Вас просят «подключить ChatGPT к нашим документам», вы открываете десяток статей про Qdrant, LangChain и fine-tuning, заливаете весь корпоративный диск - и бот уверенно цитирует регламент 2022 года, путает версии прайсов и отвечает из головы, пока IT обещает «разработчика на месяц». За один вечер можно собрать узкий пилот RAG на 20-50 файлах: no-code стек, промпт с цитатой источника и 20 реальных вопросов сотрудников - без единой строки Python.
TL;DR / Быстрый инсайт: RAG (retrieval augmented generation) - это не «обучить модель на Wiki», а поиск нужных фрагментов в ваших файлах и ответ LLM строго по ним. Старт: один отдел, 20-50 актуальных документов, temperature 0, ответ со ссылкой на источник. Цель пилота - минимум 16 из 20 тестовых вопросов с верным документом; при пустой базе бот говорит «не знаю», а не выдумывает.
Дмитрий из продаж залил в «умного ассистента» 800 PDF с диска S:. На демо бот блестяще отвечал на три вопроса про доставку. Через неделю менеджеры поймали его на старом SLA 2023 года: в индексе лежали две версии договора без даты, а temperature стояла 0.7 «чтобы звучало живее». После среза до 35 утвержденных файлов, temperature 0 и 22 тестовых вопросов из реальных чатов FAQ для новичков стал рабочим.
Типичная ошибка - верить, что чем больше документов, тем умнее бот. У Alpina Digital на Habr (2026) из 12 000 «актуальных» файлов после аудита осталось около 3 800 - дубликаты и черновики. Качество поиска выросло кратно без нового кода. По Вордстат (июнь 2026, РФ): «rag база знаний» - 406 показов/мес, «rag система» - 1972; держим фокус на узкой корпоративной базе, а не на RAG на весь архив.
Сузьте пилот до 20-50 документов одного домена
Боль: залили всю Wiki - бот путает версии и галлюцинирует. Решение - один процесс и одна папка: FAQ саппорта, онбординг HR или регламенты продаж. Важно: не расширяйте пилот, пока не закрепите список из 20 вопросов.
- Выберите домен - где вопросы повторяются в чатах (не «вся компания»).
- Соберите 20 реальных вопросов из переписок или тикетов - список не меняйте при настройке.
- Отберите файлы-ответы - регламенты, FAQ, прайсы с датой в названии.
- Выбросьте архив - черновики, «финал 2», договоры без года.
- Ограничьте доступ - пилот на одном отделе до прогона тестов.
На Habr: загрузка всей Wiki ухудшила ответы, узкий раздел SQA - наоборот. Срез до документов за два года (около 400 вместо 3000) дал резкий рост качества. Порядок в папке «Важное финал 3» важнее выбора между Qdrant и pgvector. На практике владелец процесса собирает пилот быстрее интегратора, который ждет ТЗ на «всю базу знаний»: один шкаф документов, один чат для команды, чек-лист точности - как навести порядок в папке, а уже потом подключать нейросеть.
Почистите дубли и нарежьте тексты на чанки перед загрузкой
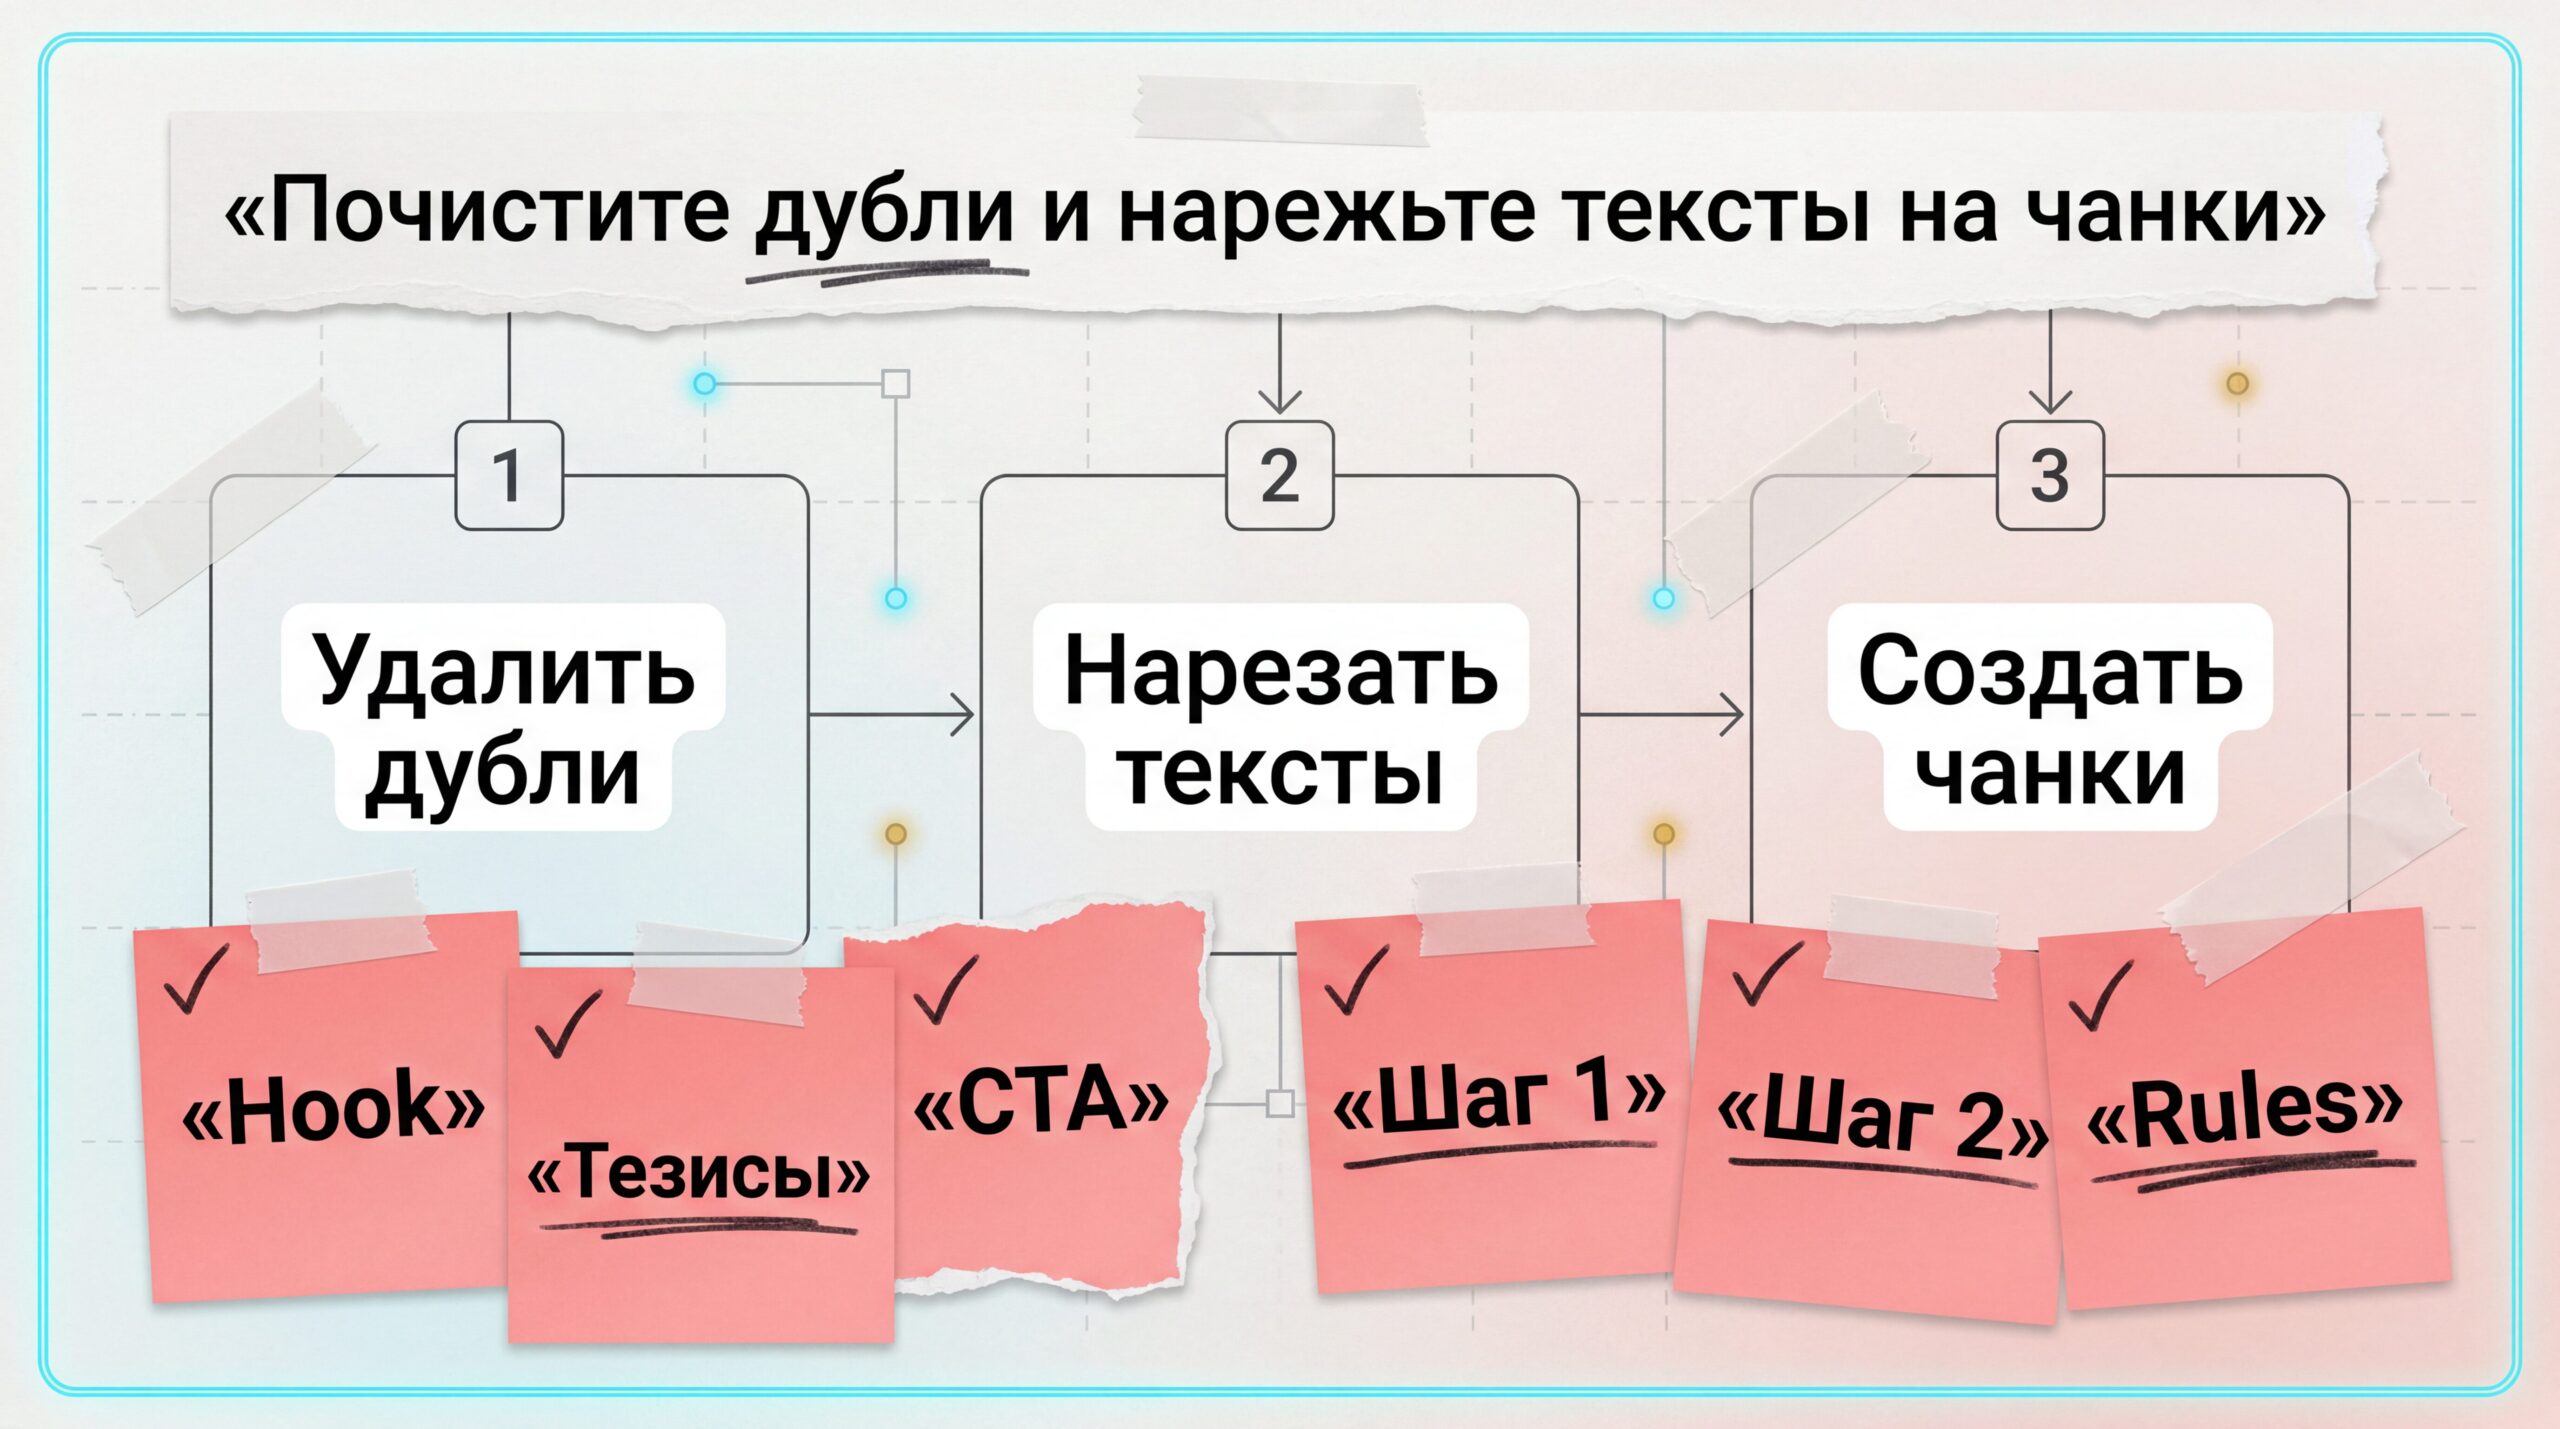
Боль: в индексе две версии прайса - retrieval тянет случайную. Решение - аудит до загрузки: владелец файла, дата в метаданных, чистый текст вместо «мертвых» PDF.
Чанкинг - нарезка документа на куски под контекст модели. Эмбеддинги - числовые «отпечатки» смысла; их кладут в векторное хранилище (Qdrant, pgvector, Chroma или Simple Vector Store в n8n). По запросу система ищет ближайшие куски - как библиотекарь, который находит полку, а не пересказывает книгу наизусть.
Старт по LangChain knowledge base: 400-512 токенов на чанк (или 500-1000 символов), overlap 10-20%, в metadata - путь заголовка, дата, версия. Убедитесь, что дата и версия файла попали в metadata до загрузки. Избегайте колонтитулов и сканов без OCR. Типичная ошибка: нарезать посередине таблицы с тарифами - тогда retrieval приносит половину цифр. Лучше режьте по абзацам через RecursiveCharacterTextSplitter, а не по случайному символу.
Схема индексации: Файлы → очистка и дедуп → чанки → эмбеддинги → векторная БД → вопросы сотрудников
Выберите no-code стек: n8n, managed KB или облачный ассистент
Боль: «нужен программист и LangChain на месяц». Для первого вечера хватает n8n: Default Data Loader → Embeddings → Vector Store → AI Agent с tool query knowledge base (RAG in n8n) или managed KB с загрузкой файлов.
| Критерий | n8n + vector store | Managed KB |
|---|---|---|
| Кто настраивает | Операционист без Python | Владелец базы знаний |
| Гибкость | Webhook, свой промпт, логи | Быстрый старт, меньше контроля |
| Пилот 20-50 docs | Да, за вечер | Да при корпоративном тарифе |
Self-hosted Qdrant или pgvector - когда появятся ПДн и требования ИБ. Для первого вечера Simple Vector Store в n8n или managed-ассистент с загрузкой PDF закрывают задачу; лучше managed KB, если нет своего DevOps. В реальном проекте часто ломается не выбор БД, а отсутствие владельца актуальности: кто обновляет прайс и выкидывает старую версию из индекса. После рабочего FAQ логично подключить ИИ-агента в n8n с тем же vector store как tool; для Cursor - подключение MCP к одной задаче.
Подключите embedding, retrieval и LLM: top_k и гибридный поиск
Боль: бот «понимает смысл», но промахивается по номеру пункта регламента. Решение - гибрид: векторный поиск плюс BM25 (поиск по словам). Включите hybrid для FAQ с цифрами и артикулами.
Пайплайн LangChain RAG: Load → Split → Embed → Store → top-k → ответ LLM. На старте top_k 3-10 чанков; больше - шум в контексте, меньше - риск «не нашли нужный абзац». Temperature 0 для фактов: модель не должна «оживлять» формулировки. 80% корпоративных задач закрывается RAG без агентов (Alpina Digital, 2026) - GraphRAG на старте чаще дороже в поддержке в три раза. Не стоит поднимать temperature «для дружелюбия» - получите уверенный ответ не из базы.
Зафиксируйте системный промпт: только контекст, цитата, fallback «не знаю»
Боль: нет доверия без источника. Решение - system message: только контекст, файл и раздел в ответе, при нехватке данных - «не знаю» или эскалация.
Каркас промпта: Ассистент по регламентам [отдел]. Только фрагменты из контекста. В конце - источник: файл и раздел. Нет данных - «В базе нет данных», предложи тикет. Не додумывай. Temperature: 0.
Кейс vc.ru: точность 56% → 89% после чистки базы, не смены модели. Human-in-the-loop на спорные темы снимает риск «ИИ заменит экспертов». Около 80% внедрений ИИ в бизнесе не достигают ожиданий (РИА Новости, май 2026) - чаще из-за размытой задачи.
Прогоните 20 тестовых вопросов и зафиксируйте критерий готовности
Боль: демо блестит, через месяц качество падает. Решение - eval из 20 вопросов и повтор после каждого обновления базы.
- Задайте вопрос из фиксированного списка.
- Проверьте факт по актуальному файлу.
- Проверьте источник в ответе.
- Проверьте отказ на вопрос вне базы.
- Запишите промахи - правьте базу, не модель.
Цель пилота - 16+ верных из 20 (80%). Метрики RAGAS (Faithfulness, Context Recall) пригодятся позже; сейчас достаточно ручного счета и лога промахов. Кейс vc.ru: 56% → 89% после структурирования базы. После смены прайса - снова 20 вопросов. Обновление: webhook в n8n при публикации файла или ежемесячный батч; без процесса бот тихо устареет, как в истории Дмитрия.
Success criteria: 16+ из 20 ответов по актуальному документу с источником; при пустой базе - «не знаю» или эскалация; один отдел, одна папка. Итог: вы сможете запустить FAQ без программиста; если критерий выполнен - готово, можно масштабировать на второй отдел. Если 12 из 20 - чистите дубли, не покупайте «более умную» модель.
Что дальше: (1) переиндексация при смене файла; (2) hybrid search для запросов с номерами пунктов; (3) бот в Slack/Telegram через n8n; (4) eval до 50 вопросов перед вторым отделом.
Разобрать пилот под ваш процесс на neuroalex.site - один шкаф документов, один чат, чек-лист точности.
Редакционная проверка: Елена Ковалева, главный эксперт по SEO/GEO.
Источники: документация n8n RAG и LangChain, кейсы Habr и vc.ru; частотности Вордстат - июнь 2026, РФ.
Частые вопросы
Чем RAG отличается от fine-tuning и когда что выбрать?
RAG ищет актуальные фрагменты при каждом вопросе - базу обновляют за минуты. Fine-tuning вшивает знания в модель: дороже и хуже для меняющихся регламентов. Для внутренней базы с версиями документов начинайте с RAG.
Нужен ли свой сервер для векторной базы на старте?
Нет. Пилоту хватит Simple Vector Store в n8n или managed KB. Свой Qdrant - при ПДн и ИБ после успеха на 20-50 документах.
Сколько документов достаточно для первого пилота RAG?
20-50 актуальных файлов одного домена. Этого хватает на 20 тестовых вопросов и решение, тянет ли узкий продакшен. Весь архив на старте почти всегда ухудшает ответы.
Что такое чанкинг и overlap простыми словами?
Чанкинг - нарезка текста на куски по 400-512 токенов. Overlap 10-20% - перекрытие соседних кусков, чтобы фраза на стыке абзацев не потерялась.
Зачем гибридный поиск, если есть эмбеддинги?
Эмбеддинги ловят смысл («как оформить отпуск»), BM25 - точные номера и артикулы. Вместе закрывают и смысловые, и «бухгалтерские» запросы.
Как часто обновлять базу знаний после запуска?
При смене регламента или прайса - переиндексация и снова eval. Минимум - ежемесячный батч и 20 контрольных вопросов, иначе бот тихо устареет, как у Дмитрия со старым SLA.