Библиотека Gemini ADK (Google Agent Development Kit) получила первое крупное ускорение от автономного ИИ: модель Gemini 4 Argon одиннадцать часов без участия человека оптимизировала репозиторий на 205 тысяч строк кода. Но громкая цифра «ускорение на 40%» оказалась не магией, а строгим инженерным компромиссом. Из шести предложенных моделью решений разработчики приняли только два, а сам выигрыш коснулся лишь подготовки истории диалога в оперативной памяти перед отправкой запроса к нейросети.
Для всех, кто следит за автономными агентами-программистами, этот эксперимент Google показателен. Он очерчивает границу между тем, что алгоритм уже способен переписать за ночь, и причинами, почему результат всё ещё требует въедливого человеческого контроля.
Зачем модели отдали 200 тысяч строк кода
Библиотека google/adk-python служит базой для создания автономных ИИ-ассистентов на Python. В проекте накопилось более 800 файлов, около 205 тысяч строк кода и почти 17 тысяч модульных тестов. По мере развития фреймворка проявилась типичная проблема зрелых систем: вспомогательный код начал отнимать заметное время на каждом шаге диалога.
Главное узкое место пряталось в сервисе сессий в оперативной памяти. При каждом обращении или вызове инструмента система полностью копировала всю историю сообщений и лишь затем фильтровала события. Чем длиннее становилась сессия, тем больше ресурсов уходило на бесполезное дублирование данных. Вторая сложность касалась холодного старта: обычный импорт библиотеки сразу загружал компоненты аудио, видео, трассировку и веб-серверы, даже если требовался простой текстовый агент.
Как алгоритм провёл ночь в репозитории
Первый двухчасовой прогон без чётких правил показал риски слепой автоматизации: модель нашла проблемные места, но сломала публичную схему авторизации и проверила лишь 216 тестов из семнадцати тысяч. Ко второй попытке инженеры зафиксировали правила архитектуры в каталоге инструкций репозитория, задали одну цель и строго запретили автоматическое слияние с основной веткой — итогом должен был стать обычный пулреквест с замерами до и после.
Агент стартовал вечером и отработал одиннадцать часов без присмотра. За это время модель изучила двенадцать файлов внутренних правил, оценила базовую производительность на четырёх рабочих нагрузках и выполнила все 16 892 модульных теста. За несколько минут до финала алгоритм провёл самоаудит и успел самостоятельно исправить ошибку в собственном коде кэширования.
Практические разборы того, как современные ИИ-ассистенты справляются с реальной разработкой и автоматизацией, мы регулярно публикуем в нашем сообществе в Telegram.
Какие две идеи прошли строгое ревью
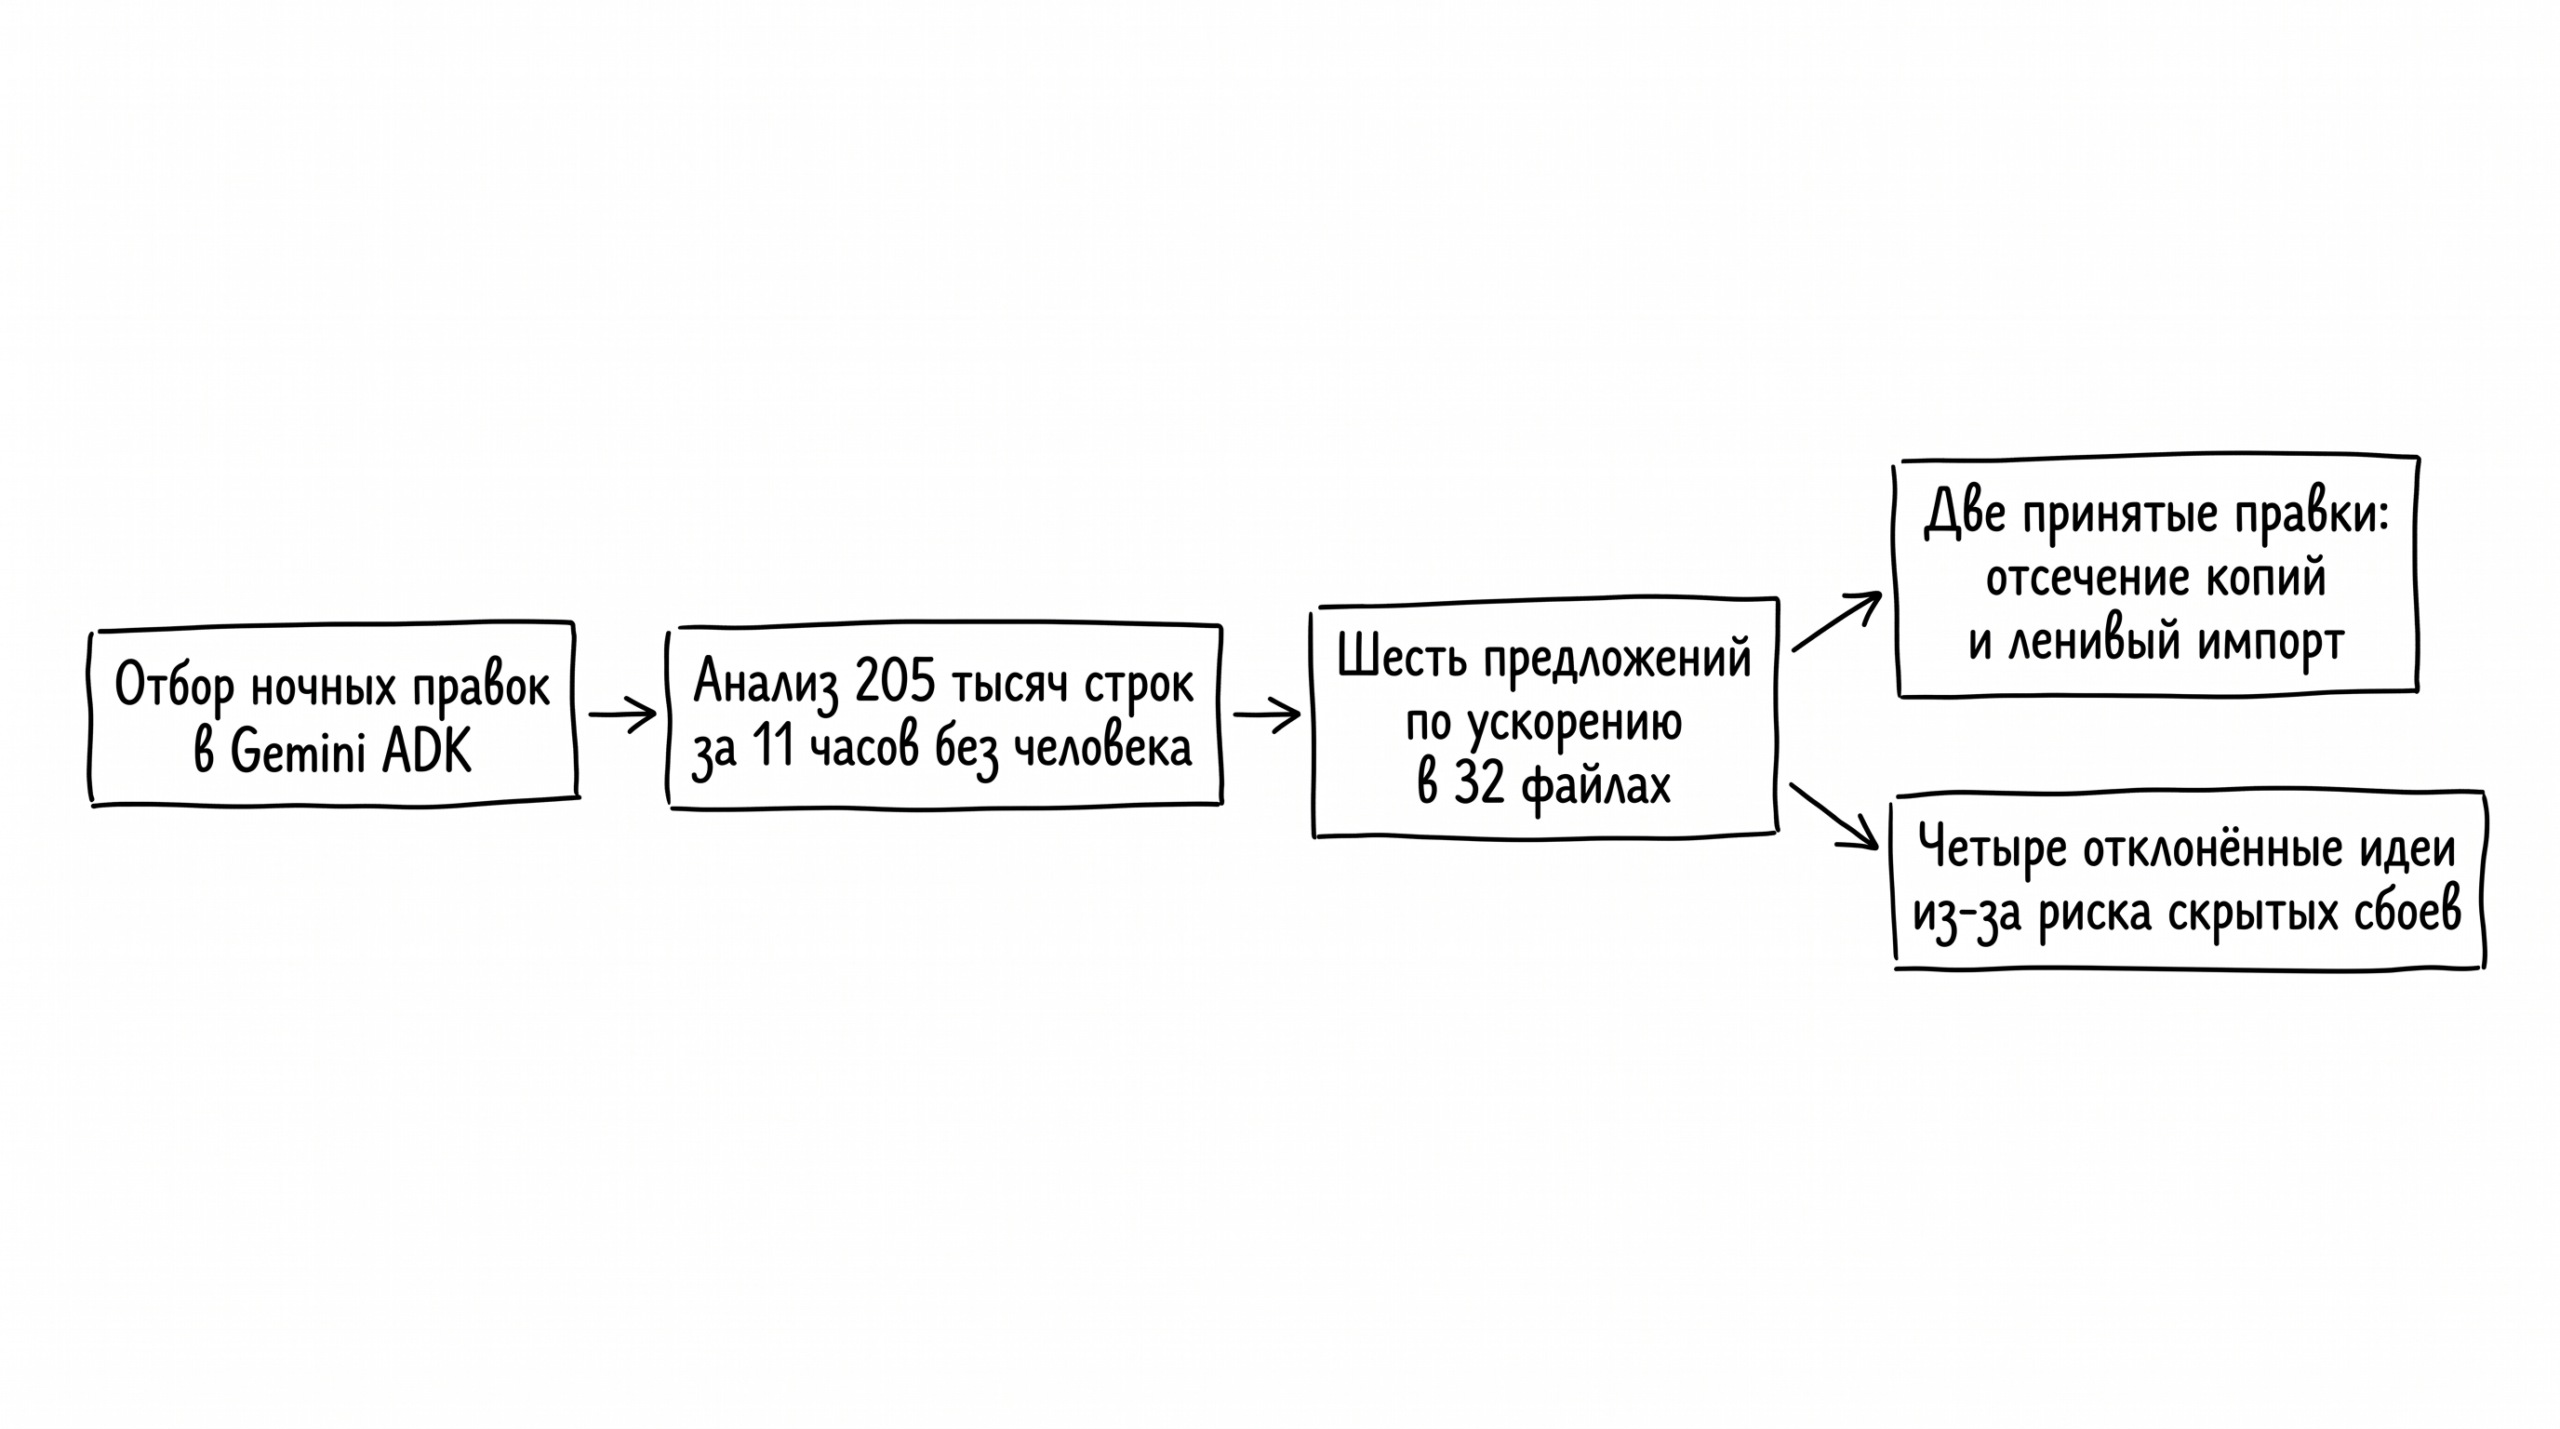
Утренний пулреквест содержал шесть предложений по оптимизации в 32 файлах. После детального разбора разработчики оставили только два изменения, затронувшие 22 файла и подкреплённые семнадцатью новыми тестами.
Первая принятая правка изменила порядок работы с историей сессий. Вместо полного дублирования данных код теперь сначала отбирает нужные события и копирует исключительно их, а стандартный механизм Pydantic заменили на специализированную функцию с защитой от циклических ссылок. Вторая одобренная оптимизация ввела отложенную загрузку зависимостей: веб-серверы FastAPI и Starlette, инструменты видео и сборщики телеметрии теперь подгружаются только при реальном обращении, сохраняя доступ к подмене атрибутов в тестах.
Почему четыре оптимизации отправились в корзину
Остальные четыре идеи инженеры отклонили, и именно это решение подчеркивает разницу между синтетическими тестами и стабильной эксплуатацией. Модель стремилась любой ценой уменьшить время на замерах, не учитывая скрытые побочные эффекты.
Кэш событий между агентами давал 17% прироста скорости, но использовал слабые ссылки в памяти: при переиспользовании адресов сборщиком мусора Python система могла вернуть устаревшие данные. Проверку телеметрии отклонили из-за привязки к приватному атрибуту библиотеки OpenTelemetry, который мог сломаться при любом обновлении. Новое форматирование истории перед отправкой в нейросеть запутало код и не показало выигрыша на независимом бенчмарке, а индекс для повтора сценариев помогал лишь искусственным тестам.
Где на самом деле спрятались сорок процентов
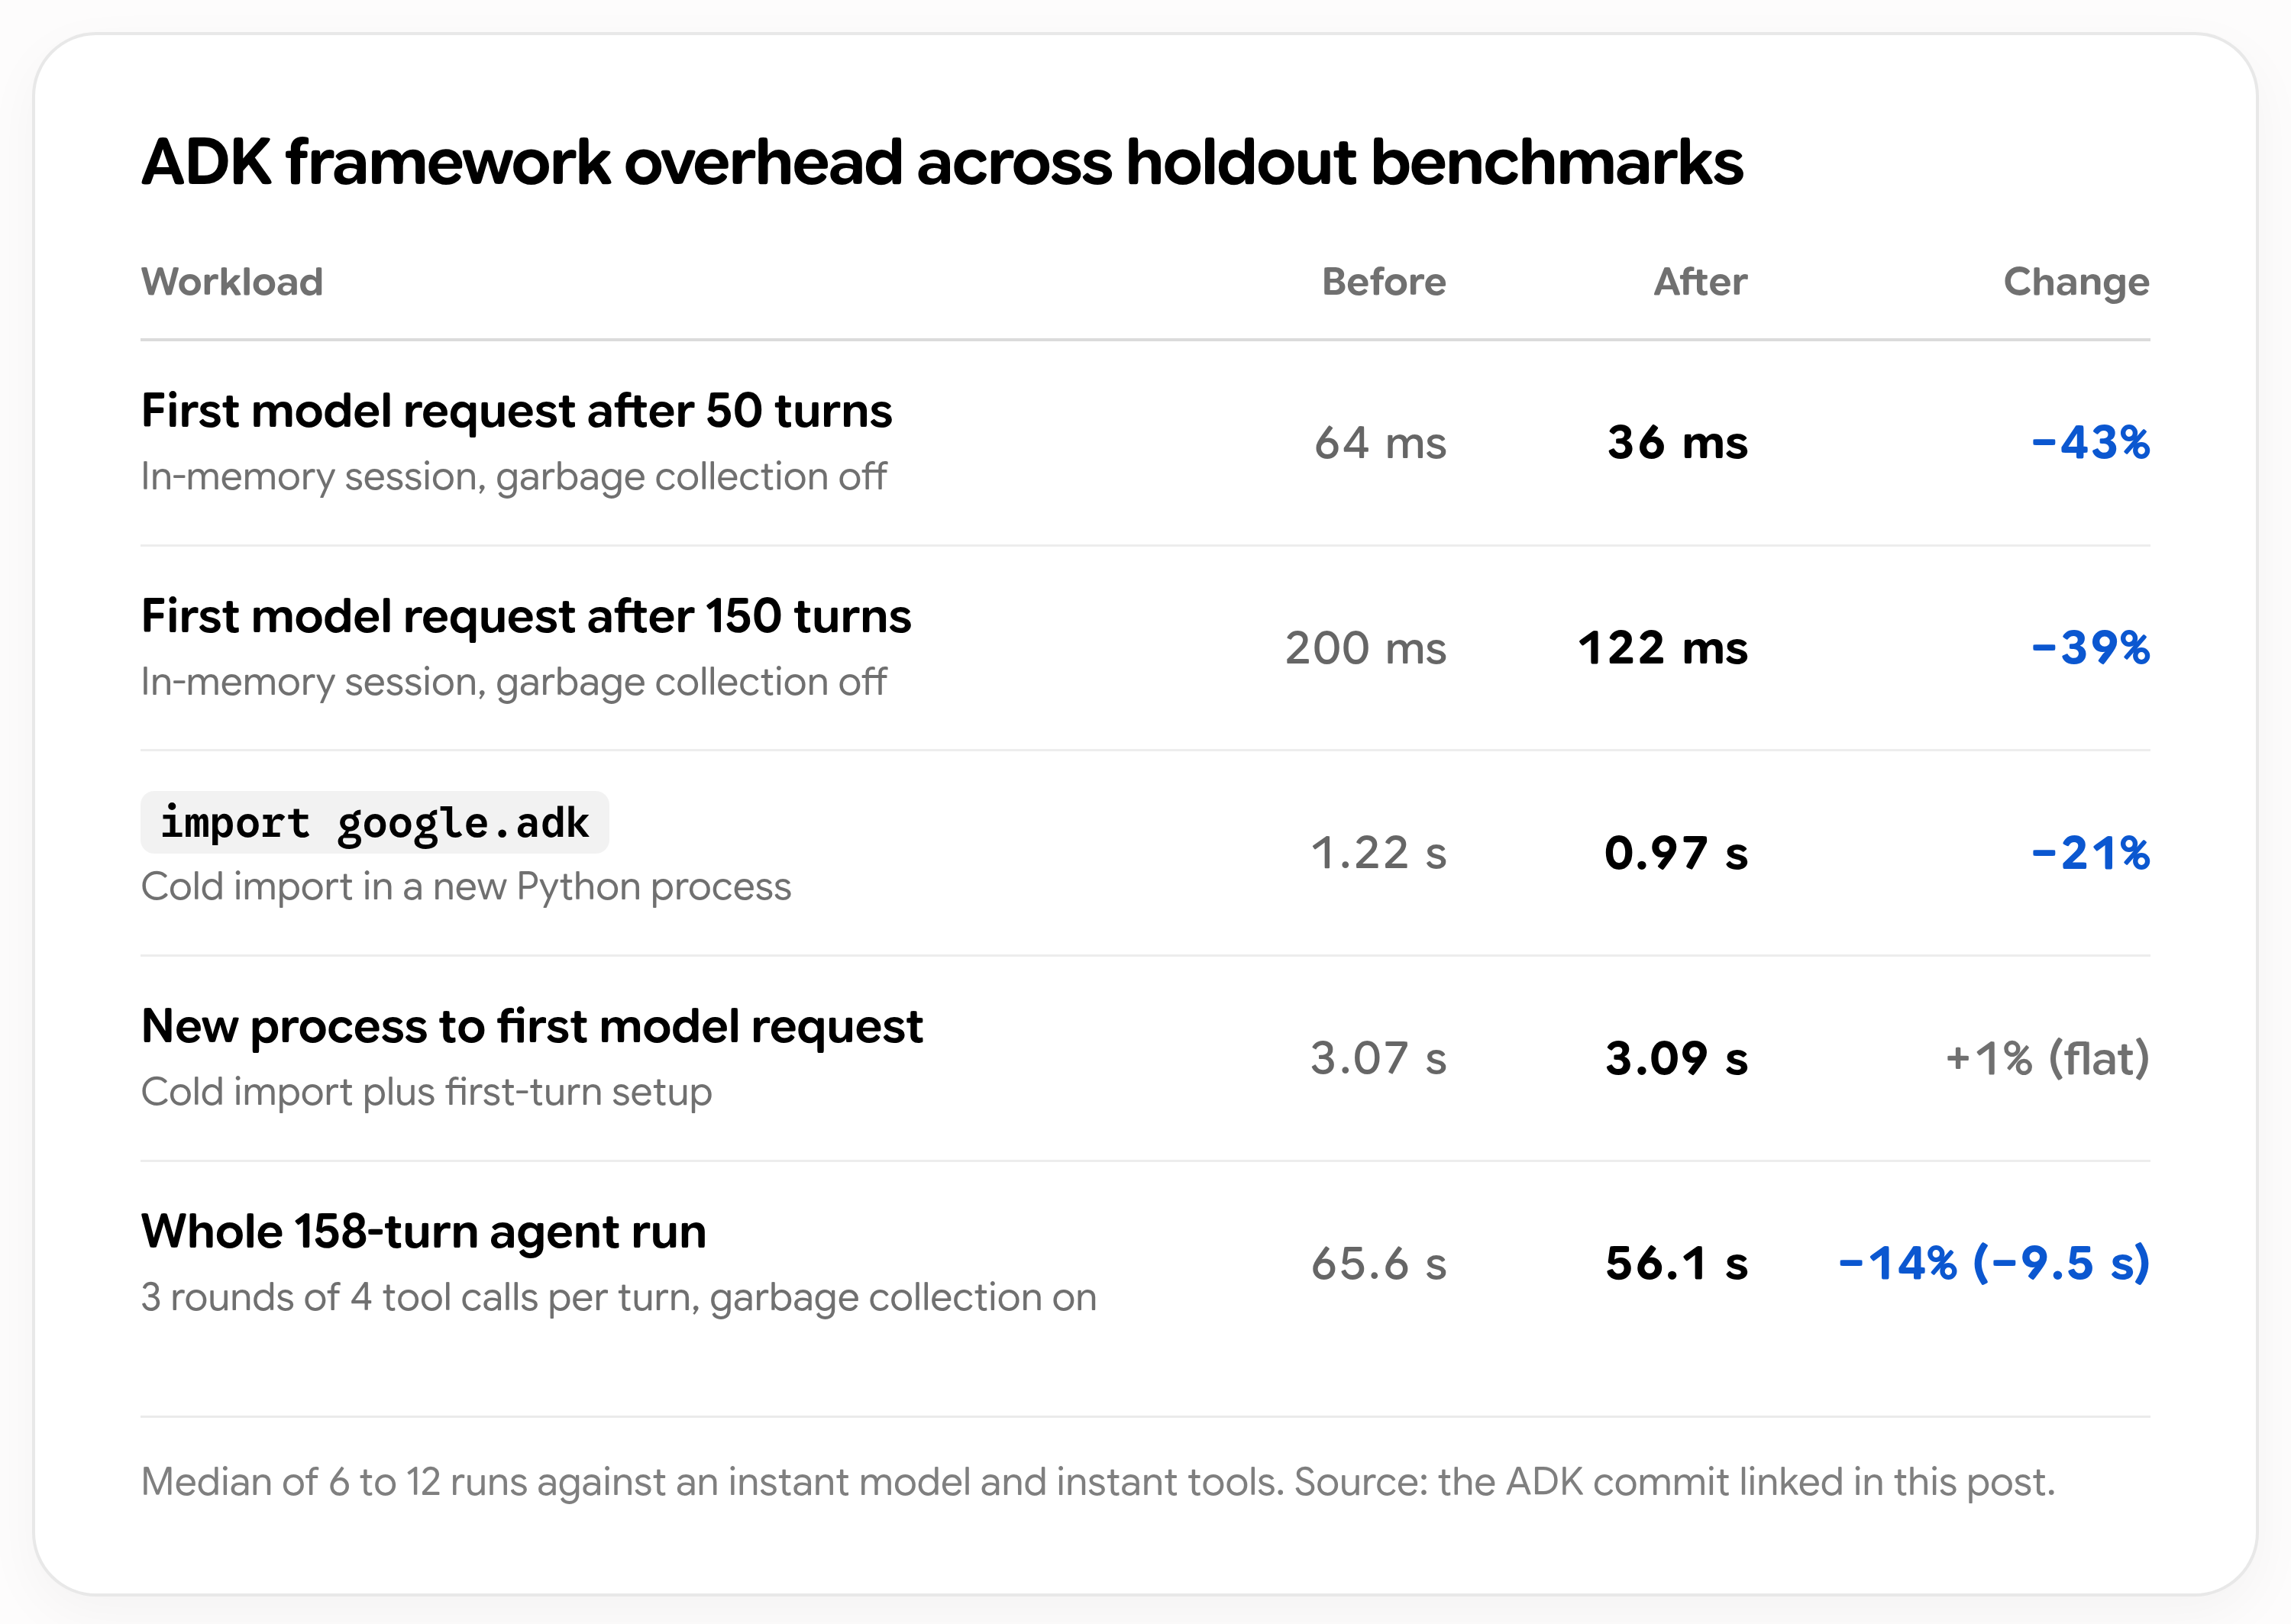
Контрольные замеры подтвердили заявленное ускорение: на длинных сессиях задержка перед первым запросом к модели сократилась на 43% после 50 шагов (с 64 до 36 миллисекунд) и на 39% после 150 шагов (с 200 до 122 миллисекунд). Сам импорт библиотеки ускорился на 21% — с 1,22 до 0,97 секунды.
Но эта оптимизация работает строго локально: она ускоряет сервис InMemorySessionService, который используется в тестах, локальной отладке и базовых контейнерах без внешней базы. Если проект подключён к SQLite, Redis или облачным хранилищам, чтение данных с диска или сети быстрее не стало.
Кроме того, на полном цикле из 158 шагов общее время выполнения сократилось всего на 14% — с 65,6 до 56,1 секунды. А путь от запуска нового процесса до первого ответа нейросети не изменился вовсе (3,07 против 3,09 секунды), так как отложенные модули всё равно загружаются на первом витке. Когда сам ответ модели занимает секунды, экономия в десятки миллисекунд неощутима для пользователя.
Главный вывод авторов библиотеки прост: автономные агенты отлично находят узкие места и генерируют гипотезы, но задача человека — отсекать опасные компромиссы. Доверять ИИ прямой коммит в рабочую ветку пока нельзя, но в роли ночного исследователя с обязательным утренним ревью он уже приносит измеримую пользу.