Генерация текста нейросетями — это процесс пошагового предсказания следующего токена на основе анализа языковых закономерностей из огромных массивов данных. Надежность этого механизма напрямую зависит от архитектуры модели, качества исходного датасета и точности промпта.
На днях наблюдал, как очередная команда стартаперов пыталась заставить базовую LLM написать им сложный технический продукт с нуля одним запросом. Выглядело забавно. Ребята думали, что магия случится сама, но на выходе получили неработающий скрипт на Python. То есть… подождите, лучше так: они получили набор символов, отдаленно напоминающий код, который пришлось переписывать вручную.
Хайп вокруг vibe coding tools вроде Cursor, Antigravity или v0 часто затмевает базовое понимание того, как работают языковые модели. Если мы не понимаем механику предсказания текста, любая автоматизация превратится в хаос генерируемого бреда. Начинающим кажется, что достаточно нажать кнопку, и система сама выдаст готовые Seo/geo оптимизированные сайты и статьи. На практике все работает иначе. Посмотрим на реальные факторы, влияющие на предсказуемость ИИ, и способы сборки надежных конвейеров.
Анатомия надежной генерации
Шаг 1. Понимание физики процесса и ограничений
Нейросеть не обладает сознанием. Она опирается на вероятности. Качество ответов падает, если вы даете размытые инструкции. Чтобы повысить надежность, нужно использовать функции «Обоснуй» для проверки логики модели и «Поиск» для актуализации данных из интернета. Типичная ошибка на этом этапе — доверить создание фактуры генеративной модели без доступа к сети. Модель начнет галлюцинировать.
Шаг 2. Выбор профильного инструмента
Разные задачи требуют разных мощностей. Использовать одну модель для всего — прямой путь к провалу. Рынок стремительно меняется, и важно понимать позиционирование ключевых игроков.
| Модель / Инструмент | Специализация | Коммерческие условия |
|---|---|---|
| DeepSeek-R1 | Работа с кодом, анализ файлов, понимание сложного контекста. | Есть бесплатный доступ, дешевая альтернатива LLM API от OpenAI. |
| DeepSeek V4 (Ожидание) | Мультимодальность (текст, фото, видео). Оптимизация под китайские чипы. | Тарифы пока не объявлены. |
| Claude 3.5 Sonnet | Тонкая стилистика, редактура, анти-канцелярит. | Бесплатный лимит, подписка $20/мес. |
| Gemini 1.5 Pro | Анализ огромных массивов данных и длинных документов. | Доступно в тарифах Google One AI Premium. |
Шаг 3. Правило гибридного подхода
Опытные инженеры давно не пишут промпты в одно окно. Они строят цепочки. Например, Gemini собирает и анализирует сырые данные, GPT-4o отвечает за структуру и генерацию черновика, а Claude шлифует стилистику. Если сюда добавить автономные агенты для ресерча, качество возрастает кратно. Подводный камень здесь — ручной перенос данных между вкладками, который убивает все сэкономленное время.
👉 Запустить автоматизацию с CalmOpsAI (Бесплатно)
Шаг 4. No-code оркестрация рабочих процессов
Чтобы гибридный подход работал автономно, нужны инструменты вроде Make.com (бывший Integromat). Это платформа визуального программирования, позволяющая связывать API-интеграции без написания кода на Python. Как это выглядит на практике:
- Контент-завод: Make.com забирает тему из Trello, передает промпт в LLM API, получает готовый текст и сохраняет его в Google Sheets.
- Дистрибуция: Настроенный сценарий пересылает материал в WordPress или планирует автопостинг через Buffer.
- Обработка лидов: Система получает заявку с сайта, квалифицирует лид через нейросеть по заданным критериям и отправляет данные в CRM.
- Персонализация: Генерация индивидуальных лид-магнитов на лету в зависимости от ответов пользователя в форме захвата.
Ошибка новичков — строить линейные сценарии без обработки ошибок. Если API отвалится, весь процесс встанет. Всегда настраивайте маршрутизацию для сбоев.
Шаг 5. Переход к LLM-агентам и MCP
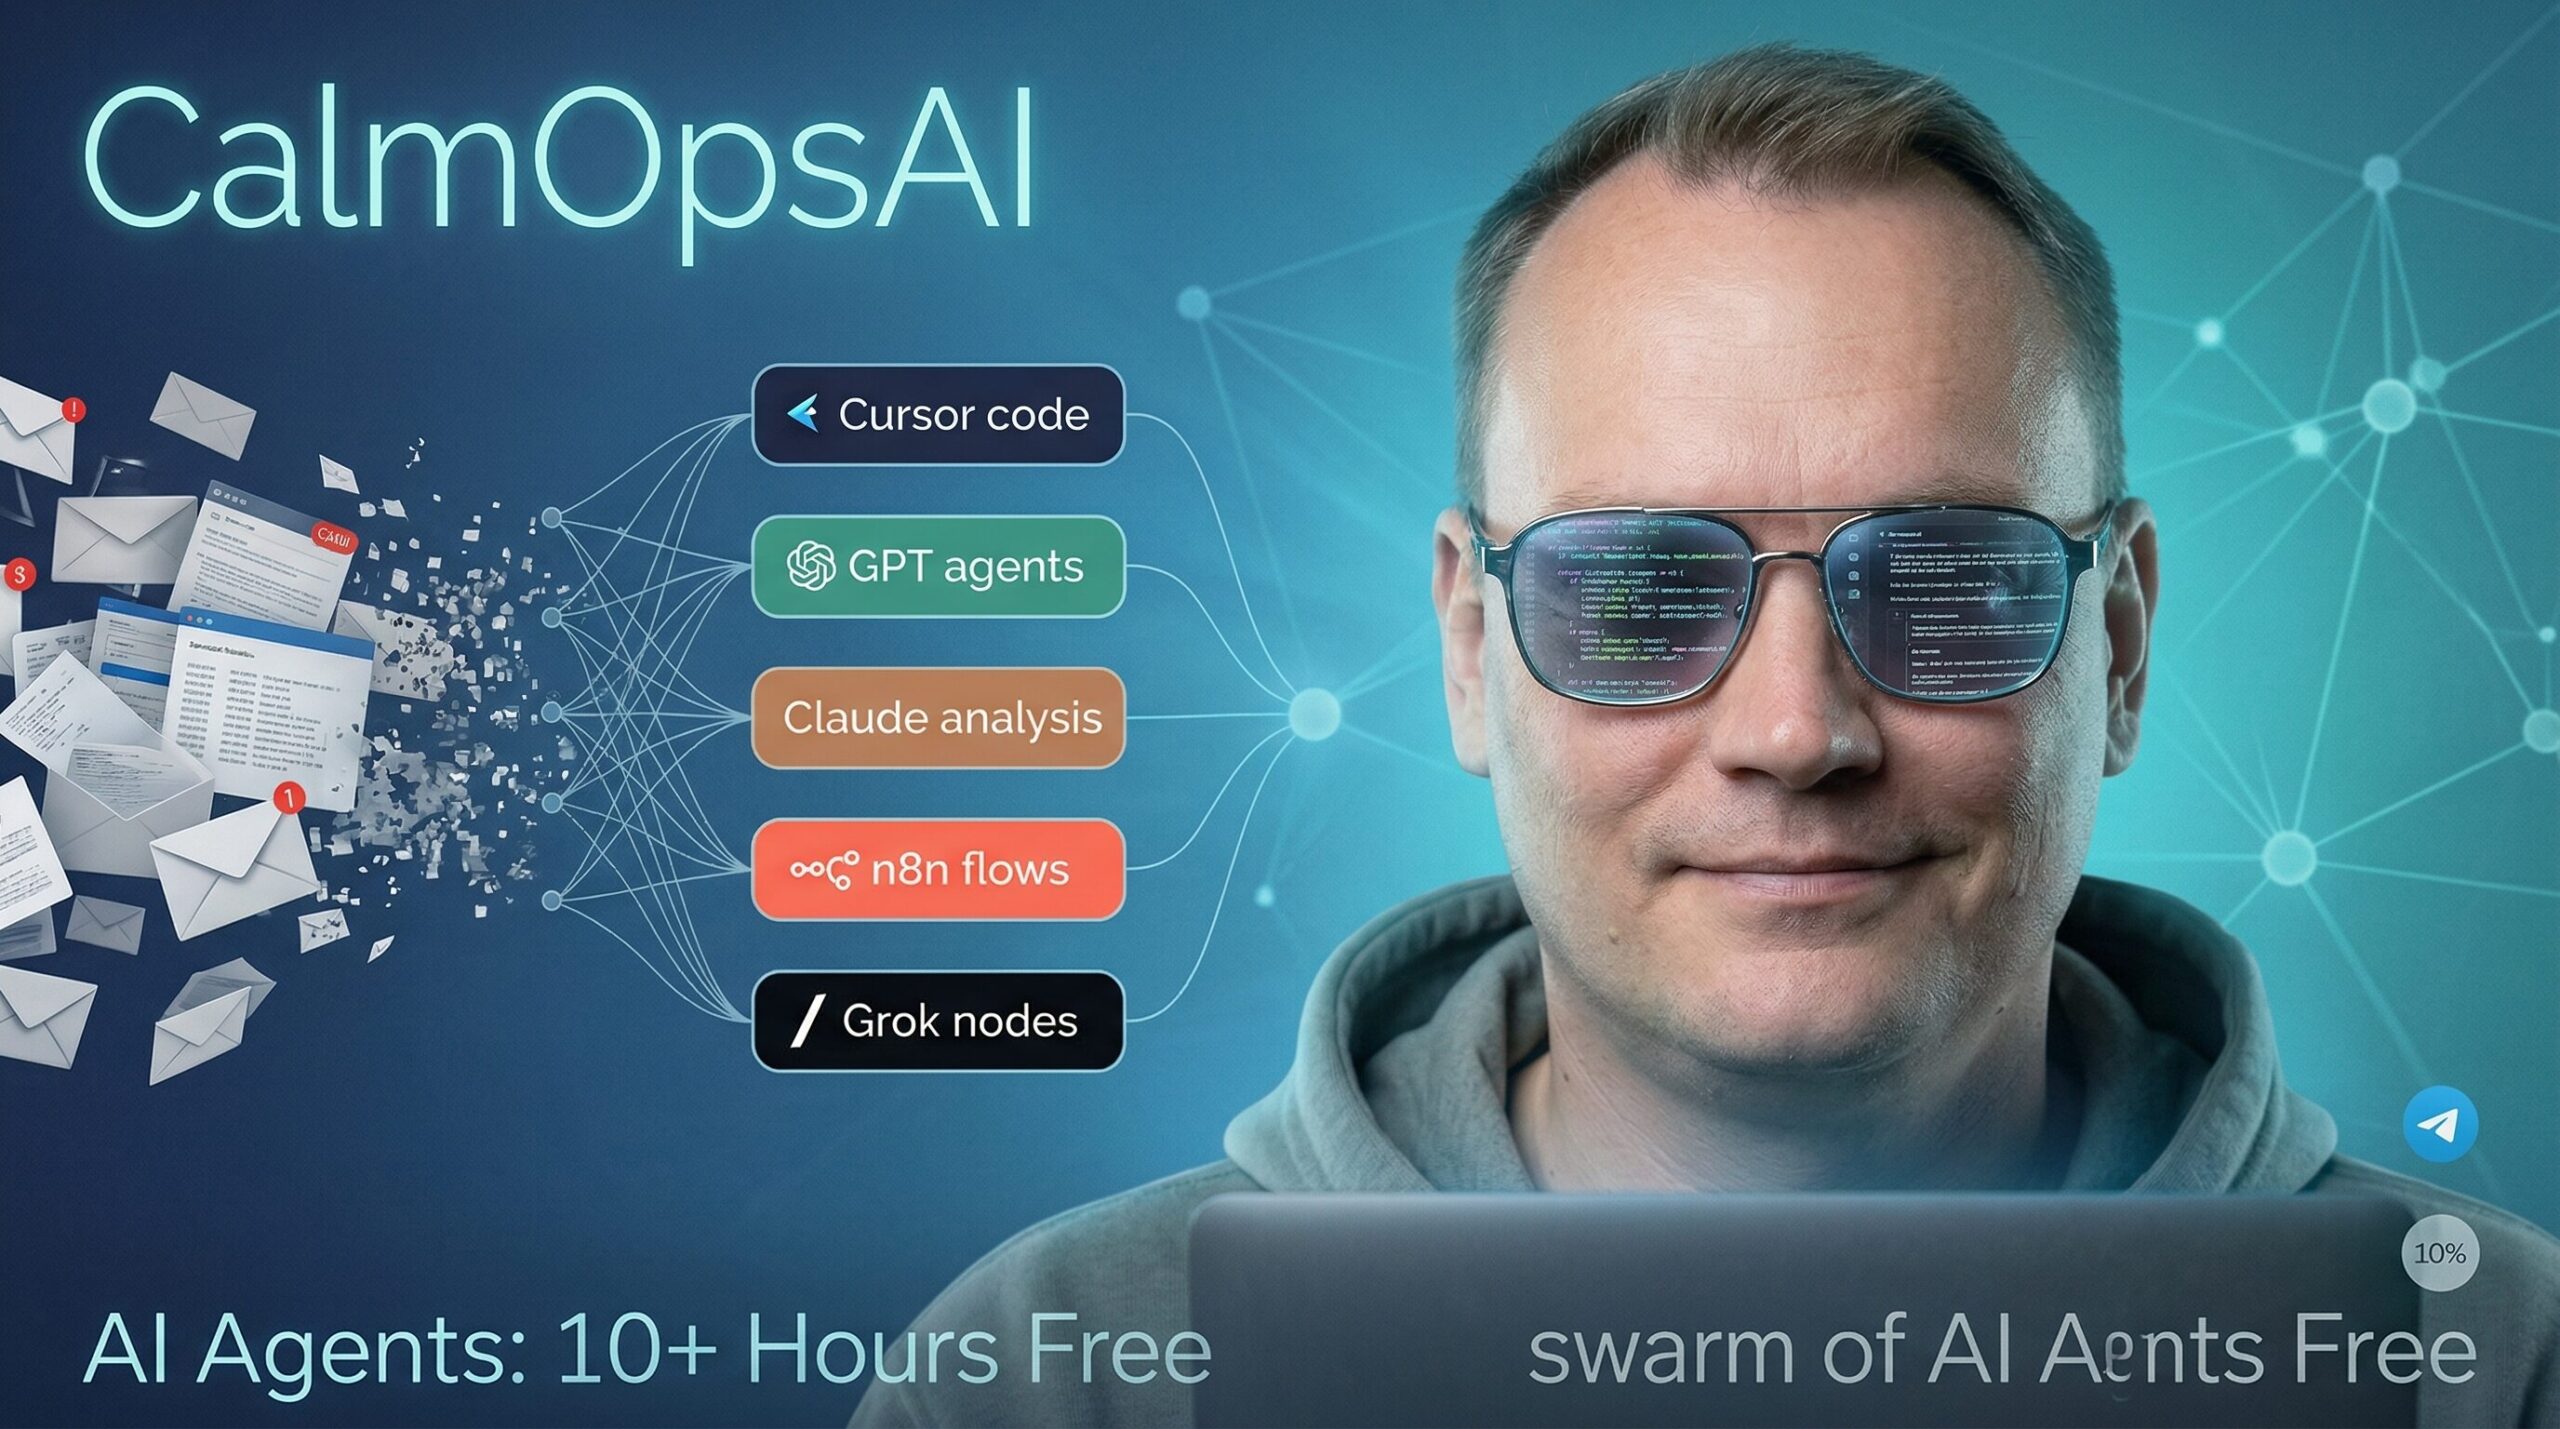
Следующий уровень эволюции — это MCP сервера (Model Context Protocol), которые позволяют агентам безопасно взаимодействовать с локальными файлами и внешними сервисами. Представьте GPT-агента на базе DeepSeek, который интегрирован в вашего корпоративного Telegram-бота через Make.com. Он не просто отвечает на вопросы, а анализирует записи телефонных переговоров, транскрибирует их и выдает рекомендации отделу продаж, опираясь на вашу внутреннюю базу знаний.
Кому комплексная автоматизация сэкономит часы жизни
Постоянная рутина съедает креативный потенциал. Связка правильных моделей с платформами автоматизации нужна тем, кто устал перекладывать данные из таблицы в документ. Выстраивая автономные системы, вы покупаете себе самый ценный ресурс — время. Это не просто красивая игрушка, а жесткая бизнес-необходимость для маркетинговых агентств, разработчиков, использующих vibe coding, и продуктовых команд. Крутой продукт, который берет на себя рутину, окупает затраты на настройку за первые несколько недель использования.
Частые вопросы
Почему нейросеть иногда выдает совершенно нелогичный текст?
Это называется галлюцинацией. Возникает из-за недостатка контекста в вашем промпте, высоких настроек температуры (креативности) или банального отсутствия нужных фактов в обучающей выборке модели. Решается добавлением примеров и жестких ограничений в запрос.
В чем главное отличие DeepSeek-R1 от ChatGPT?
DeepSeek-R1 позиционируется как более доступная по цене альтернатива, которая показывает отличные результаты в логических задачах, написании кода и работе с документами. Часто обходит базовые версии GPT по соотношению цены и качества при доступе через API.
Обязательно ли знать Python для создания LLM-агентов?
Уже нет. Инструменты no-code автоматизации вроде Make.com позволяют собирать сложных агентов визуальными блоками. Код может понадобиться только для очень специфичных кастомных интеграций, но и его сейчас пишут сами нейросети через тот же Cursor.
Что значит мультимодальность в контексте ожидаемой DeepSeek V4?
Это способность одной модели одновременно «понимать» и генерировать разные форматы данных — текст, изображения, аудио и видео. Вам не нужно будет использовать разные сервисы для картинки и поста, все произойдет в едином контексте.
Как защитить данные при передаче через Make.com в сторонние API?
Крупные платформы используют шифрование. Однако для высокочувствительных корпоративных данных лучше настраивать локальные LLM-агенты и использовать защищенные MCP сервера внутри закрытого контура компании, не отправляя коммерческую тайну в публичные облака.