Маркетолог вставил в llms.txt блок User-agent: GPTBot / Disallow из статьи про robots.txt. Валидатор упал, разработчик сказал: «это не тот файл». Боль знакомая: слышишь про llms.txt и GEO, боишься сделать «ещё один sitemap» или ждать магии от ChatGPT - и откладываешь. За вечер вы сможете собрать валидный llms.txt: Markdown с H1, blockquote и курированными ссылками, отделить его от sitemap и robots.txt, при необходимости добавить llms-full.txt и проверить файл валидатором llmstxt.org.
TL;DR / Быстрый инсайт: llms.txt - 30-минутная «визитка для агентов» в /llms.txt, не замена SEO и не копия sitemap.xml. Формат: H1, blockquote, H2 со ссылками; robots.txt - доступ, sitemap - все URL. В 2026 OtterlyAI и SE Ranking не подтверждают рост цитирований от одного файла; Stripe и Vercel используют его для доков. Соберите 10-20 канонических страниц, абсолютные https:// URL, HTTP 200, без Disallow на /llms.txt.
«llms txt» - 1014 показов/мес в Вордстат (РФ, июль 2026), «как создать файл llms txt» - ещё 15. RU-гайды часто обещают «AI-видимость за вечер» без цифр. В Limy за май 2026 из 515 млн событий AI-ботов на /llms.txt пришлось 408 запросов - при этом Stripe и Vercel публикуют файлы с .md-версиями доков, а Google Search не использует llms.txt для ранжирования (John Mueller, 2025). Честный угол: llms.txt - hygiene для агентов и coding assistants, не серебряная пуля GEO и не дубль sitemap.
Чем llms.txt не является: robots, sitemap и визитка - три разных файла
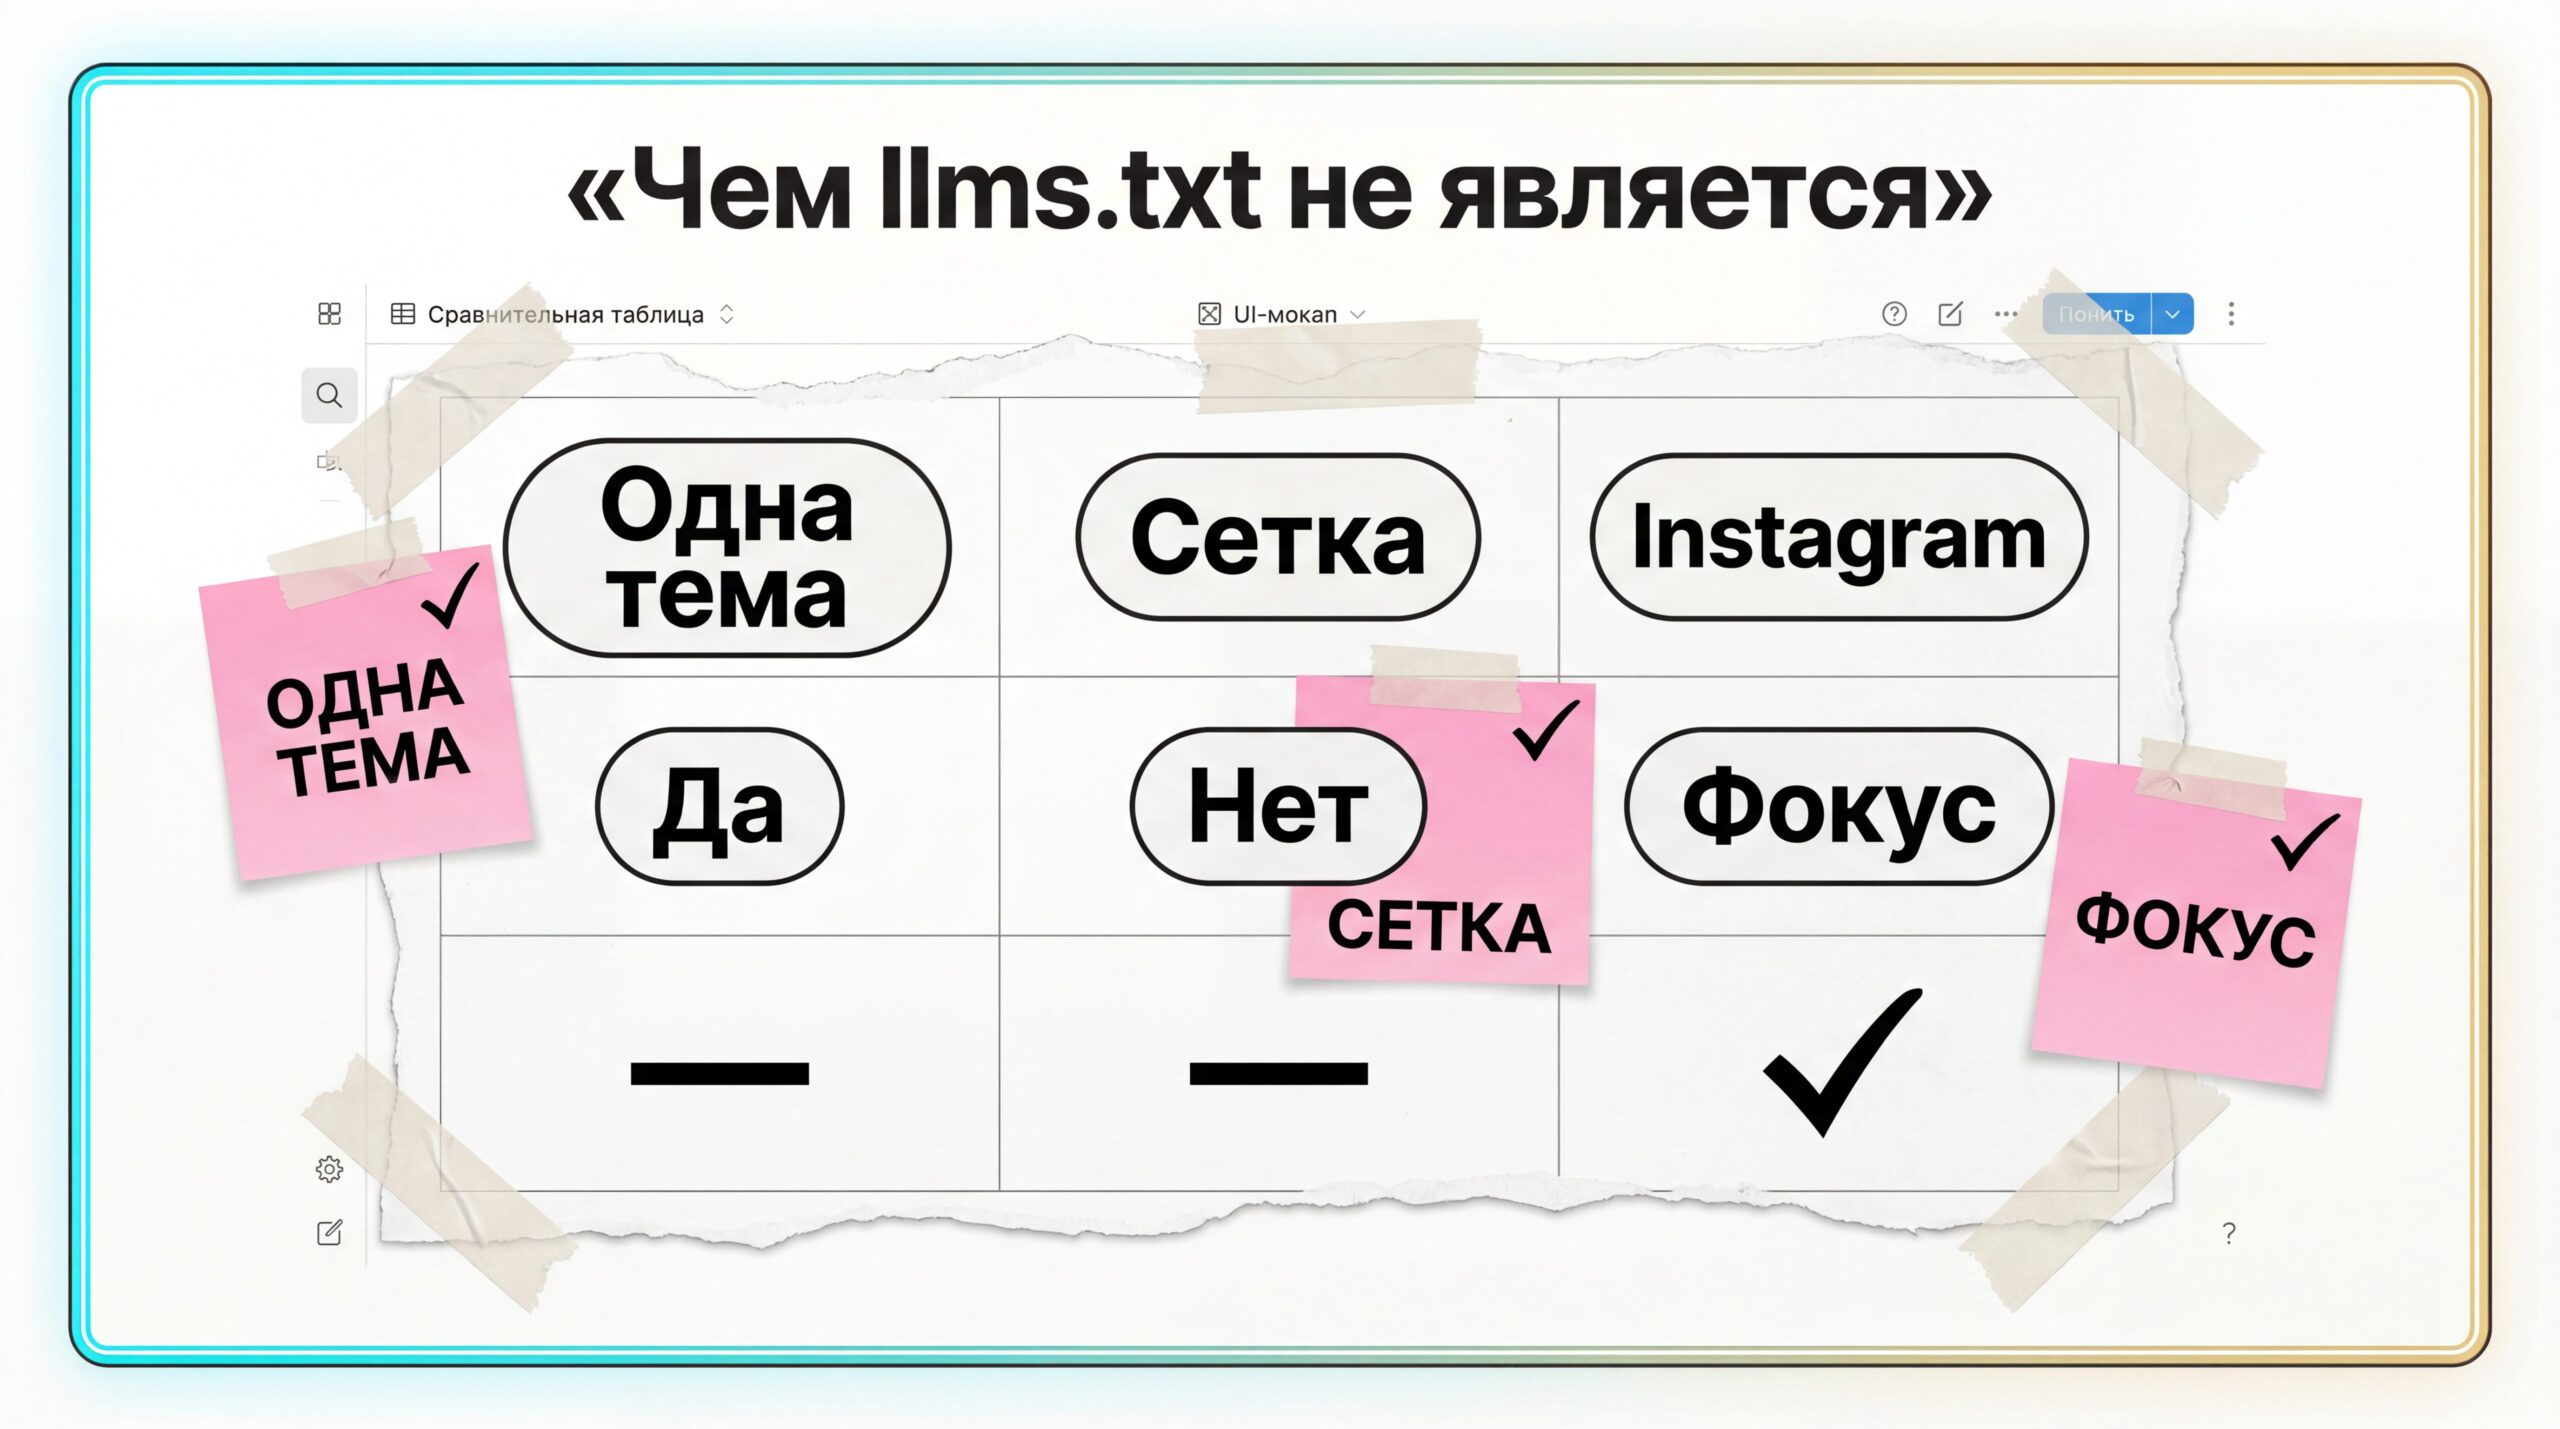
Главная ошибка - смешать роли. robots.txt говорит боту «можно / нельзя» (RFC 9309). sitemap.xml - все URL для индексации. llms.txt (Jeremy Howard, Answer.AI, 2024) - курированная карта с описаниями для LLM.
| Файл | Роль | Формат | Типичная ошибка |
|---|---|---|---|
| robots.txt | Доступ краулеров | User-agent, Allow, Disallow | Вставить синтаксис в llms.txt |
| sitemap.xml | Полный список URL | XML | Скопировать тысячи URL в llms.txt |
| llms.txt | Карта для агентов | Markdown: H1, blockquote, H2 | Ждать SEO-ранжирования |
Эталоны Stripe, Vercel и Crawloria не содержат User-agent или Disallow. Видите их в черновике - перенесите в robots.txt и начните markdown заново. Избегайте копирования всего sitemap: в llms.txt лучше 15-40 курированных ссылок за один fetch. Типичная ошибка - ложное ощущение, что через llms.txt вы «разрешили бота». Доступ настраивается только в robots.txt.
Нужен ли файл и чего не ждать
Боль: ждёте всплеск цитирований в ChatGPT от одного файла. OtterlyAI: 84 запроса к /llms.txt из 62 100 AI-запросов за 90 дней (0,1%); SE Ranking на ~300k доменов не нашёл корреляции llms.txt с AI-цитированием. Зато для SaaS, API-доков и студий с coding assistants файл даёт компактный контекст - паттерн Stripe и Vercel со ссылками на docs.*.md.
Для лендинга услуг llms.txt - разумная hygiene: о компании, услуги, кейсы, FAQ, контакты. Не заменяет JSON-LD FAQPage и answer-first текст из GEO-чеклиста - дополняет. Рекомендуем: если есть 10+ важных страниц и AI-боты не заблокированы в robots.txt - потратьте 30 минут. Не стоит ждать магии от одного файла: если цель «в ChatGPT завтра» - сначала контент, schema и crawl.
Соберите 10-20 канонических URL
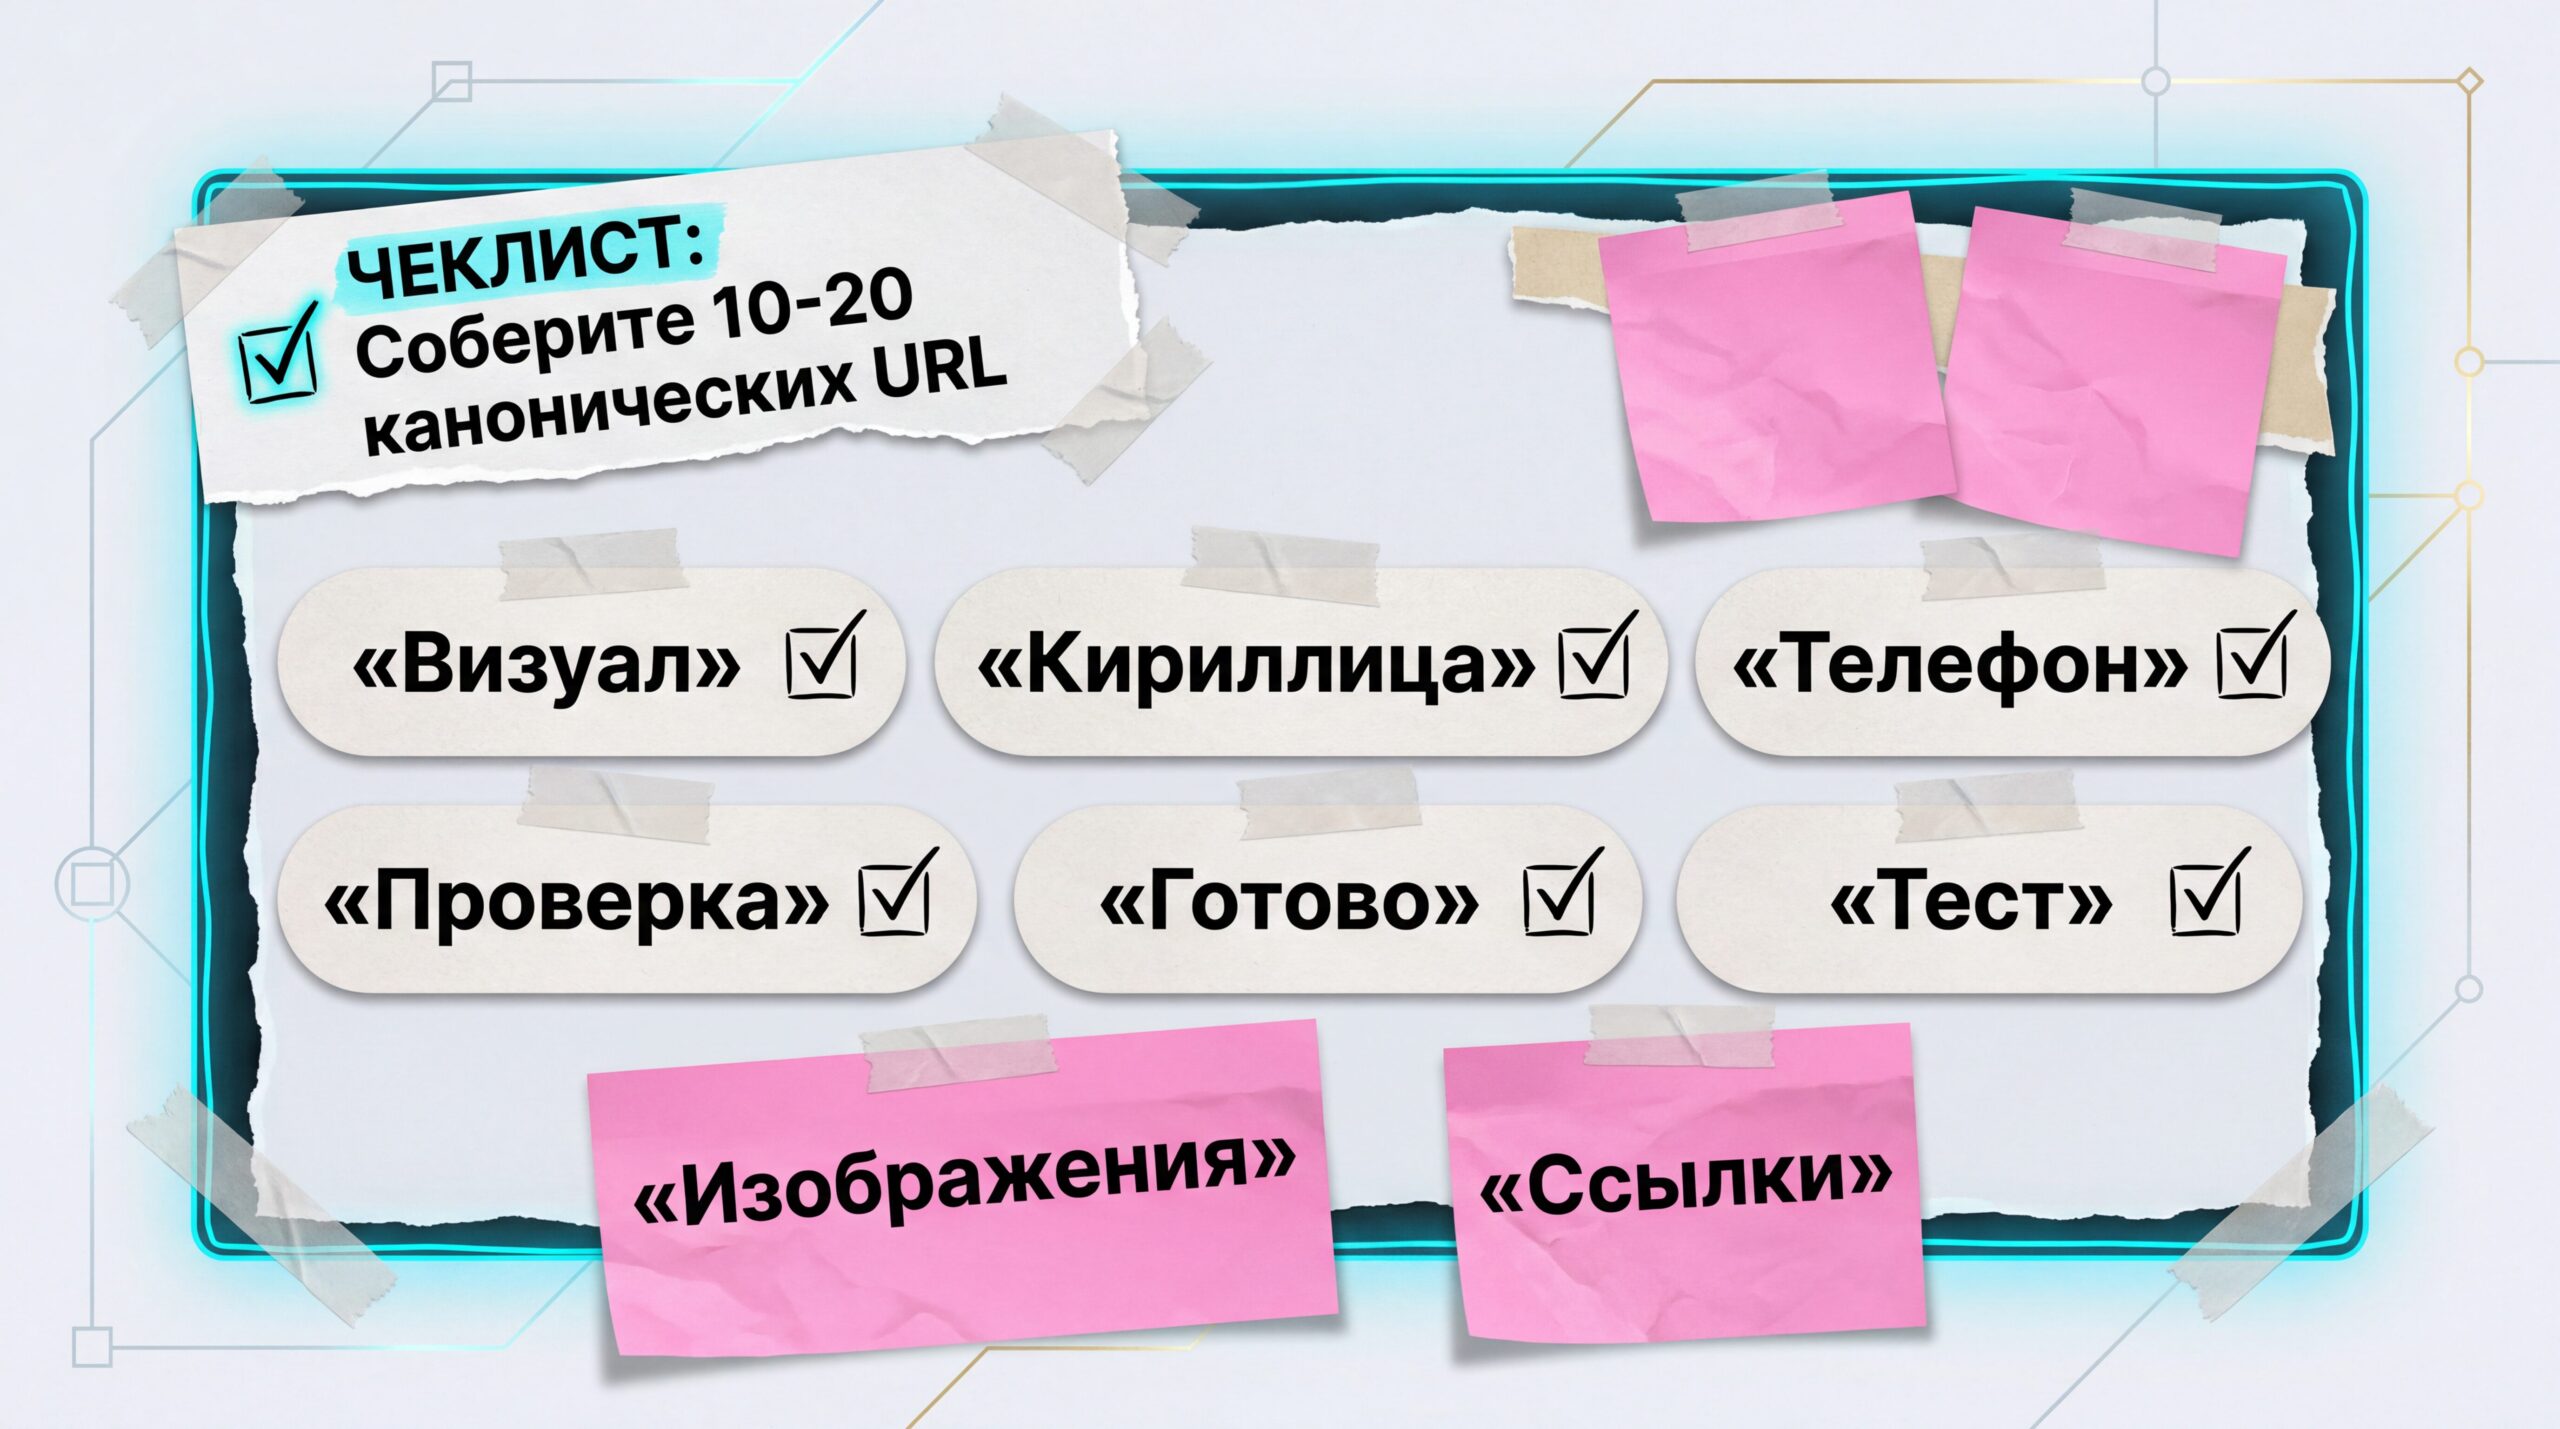
Боль: «скопирую sitemap - пусть AI всё видит». Решение - курация, не dump.
- Инвентаризация: о компании, услуги, кейсы, FAQ, контакты - не архив блога.
- Строка «зачем»: к каждой ссылке - зачем агенту открывать страницу.
- Абсолютные URL: https://example.com/pricing, не /pricing.
- Optional: блог и архив - агент может пропустить (спека llmstxt.org).
- Лимит 40 URL: остальное в Optional или llms-full.txt.
На практике генератор soamee/llms-txt-generator на GitHub собирает llms.txt из sitemap или краула - удобно для черновика. PHP aff-top/llms-txt-builder закрывает CMS-сайты. Советуем не публиковать dump из генератора: удалите служебные URL и добавьте описания «зачем». Важно: генератор не равен курации.
Минимальный рабочий файл по llmstxt.org
Обязателен только H1. Дальше blockquote, 2-3 абзаца без заголовков, H2 со списками markdown.
Пример минимального llms.txt:
# Название бренда> Кто вы и что безопасно цитировать.
Краткий контекст: чем занимаетесь и для кого.
## Основное
- [Услуги](https://example.com/services): сроки внедрения
- [Кейсы](https://example.com/cases): отрасли с цифрами## Optional
- [Блог](https://example.com/blog): статьи 2026
Топ ошибок по llmstxtvalidator.dev: relative URL вроде /docs/pricing; robots-синтаксис внутри markdown; отсутствие H2-секций; битые 404 по ссылкам из файла. Каждая строка со ссылкой начинается с `- [` и содержит полный https:// URL - внешний агент не знает ваш домен по умолчанию.
llms-full.txt: когда выносить тяжёлый контент
Если документация длинная, корневой llms.txt остаётся lean index - указатель, не энциклопедия. Паттерн Stripe/Vercel: в llms.txt ссылка на llms-full.txt и на .md-копии страниц (рекомендация llmstxt.org: page.html.md или url.md для LLM-friendly контента). llms-full.txt нужен, когда один fetch index не влезает в context window агента или сотни страниц API. Для лендинга на 15 URL full-файл чаще лишний. Оба файла в корне /llms.txt и /llms-full.txt, MIME text/plain или text/markdown, без BOM на Linux-хостинге.
Разместите на хостинге: статика, WordPress, Tilda
Wordstat «llms txt тильда» - 29 показов: часто «некуда положить». Цель - https://домен/llms.txt отдаёт 200.
Схема: черновик → корень домена → curl -I → валидатор → robots.txt → обновление раз в квартал
- Статика/VPS: llms.txt рядом с index.html.
- WordPress: FTP в public_html, не страница темы.
- Tilda: поддомен docs. или статический хостинг; абсолютные ссылки на основной домен.
В реальном проекте на Tilda файл положили на поддомен документации - в llms.txt указали абсолютные ссылки на основной домен. Проверка: откройте URL в браузере и curl -I: должен быть читаемый Markdown с кодом 200, не HTML-обёртка 404-страницы конструктора.
robots.txt рядом: не смешивайте файлы
llms.txt не копируют в robots.txt и не вставляют туда содержимое markdown. В robots добавляют Sitemap: https://domain/sitemap.xml и следят, чтобы не было Disallow: /llms.txt для ботов, которым нужен доступ (GPTBot, ClaudeBot, PerplexityBot - по вашей политике). Отдельной директивы «Llms-txt:» в RFC 9309 нет.
Запрос «llms txt в robots txt» (9 показов Вордстат) - люди ищут связку файлов. Связь простая: robots разрешает обход, sitemap даёт полный индекс, llms.txt лежит отдельно по пути /llms.txt. Блокировка GPTBot - осознанное решение в robots, не строка Disallow внутри llms.txt.
Проверка: валидатор и curl
- HTTP: curl -I https://домен/llms.txt - убедитесь в 200 и Content-Type text/plain или text/markdown.
- Спека: прогоните URL в llm-txt-validator.vercel.app - критических ошибок быть не должно.
- Провалы: relative URL; User-agent в теле; нет H1/H2; битые ссылки - проверьте каждый пункт.
- Регламент: правьте llms.txt в том же PR, что и навигацию.
Success criteria до FAQ: по адресу https://ваш-домен/llms.txt открывается Markdown с H1, blockquote и 3-5 H2; валидатор без критических ошибок; robots с Sitemap: без Disallow на /llms.txt; sitemap не продублирован. Итог: готово к работе агентов за вечер - измеримый результат, не обещание «нейросеть полюбит сайт».
Аудит GEO и автоматизации - calmopsai.com. Смежно: чек-лист GEO для ИИ-поиска.
Материал проверен: Елена Ковалева, эксперт SEO/GEO.
Достоверность: Wordstat «llms txt» 1014/мес (июль 2026); OtterlyAI 0,1%; llmstxt.org, Stripe/Vercel - research 2026-07-08.
Частые вопросы
Нужен ли llms-full.txt для SaaS?
Да, если доков больше, чем влезает в короткий index: полный корпус в /llms-full.txt, в llms.txt - ссылка и навигация. Для лендинга на 10-15 URL обычно лишний.
Заменяет ли llms.txt Schema.org?
Нет. FAQPage и answer-first остаются основой GEO; llms.txt - карта для агентов. Google не использует его как сигнал Search.
Как узнать, что боты читают файл?
Логи CDN на GET /llms.txt - хиты редкие (доли процента в данных 2026). Минимум: валидатор + curl 200.
Можно ли сгенерировать автоматически?
CLI soamee/llms-txt-generator или aff-top/llms-txt-builder дают черновик. Обязательно отредактируйте: уберите служебные URL, добавьте «зачем».
Как создать llms txt на Тильде?
Статический файл на поддомене docs. или отдельном хостинге; проверьте plain text, не шаблон конструктора.
Обязательно ли упоминать llms.txt в robots.txt?
Нет отдельной строки для llms.txt. Достаточно не блокировать /llms.txt и держать Sitemap: на sitemap.xml. Содержимое llms.txt в robots не вставляют - разный синтаксис.
Поможет ли попасть в ChatGPT быстрее?
Гарантий нет - корреляция в SE Ranking 2026 близка к нулю. Файл помогает агентам быстрее найти канонические страницы; ставьте hygiene после robots, schema и контента, не как единственную GEO-ставку.